刚刚在ICCV展示了我们的新工作Objaverse++。这是一个开源的3D物体数据集,清洗了 Objaverse 数据集并标注出其中高质量的数据,证明了使用更少但更高质量的3D 物体,能够训练出更好的生成式 AI 模型。自今年四月发布以来,它在 Hugging Face 上的下载量超过2500次。
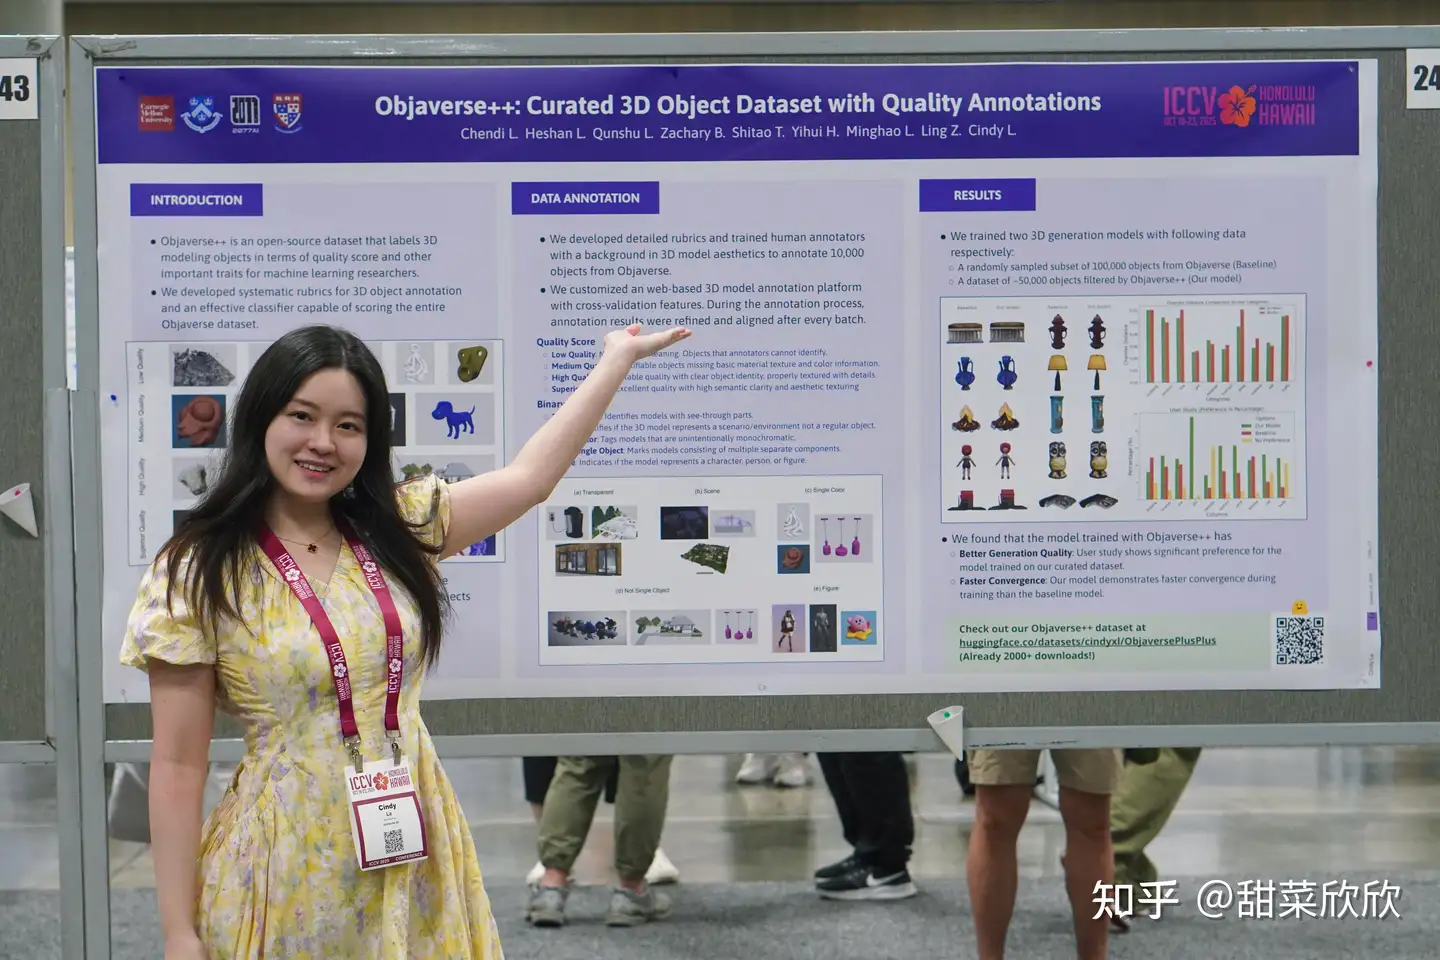
今年的 ICCV 在夏威夷举办,为期五天,参会者来自世界各地。因为临时收到通知我们可以去发言,全职创业的我安排了一个夏威夷两天的极限行程。
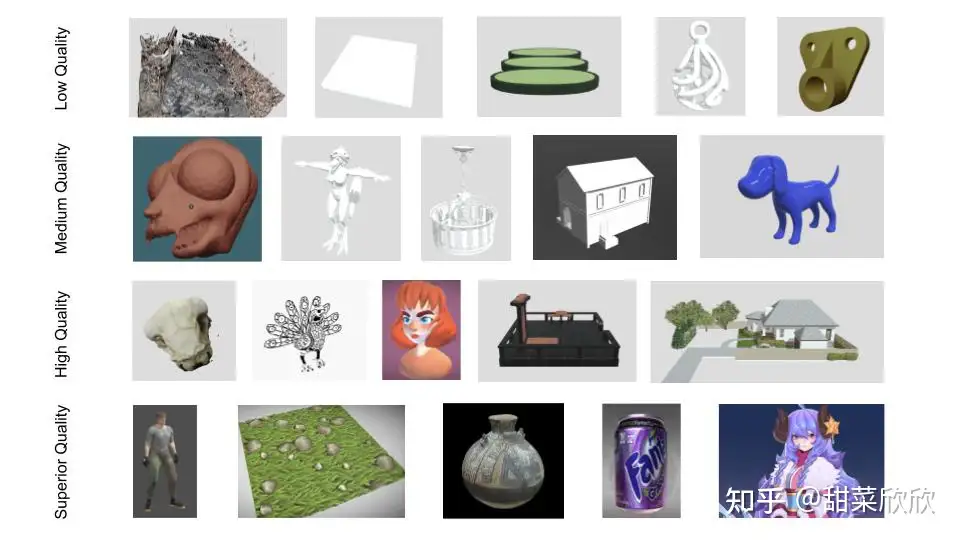
欣欣最早研究 AI 3D 生成的时候,注意到社区里可用的3D数据非常稀少。所以我们设计了系统化的标注规则,培训人工进行数据标注,然 后使用人工的数据训练一个分类器,来标注整个 Objaverse 数据集。
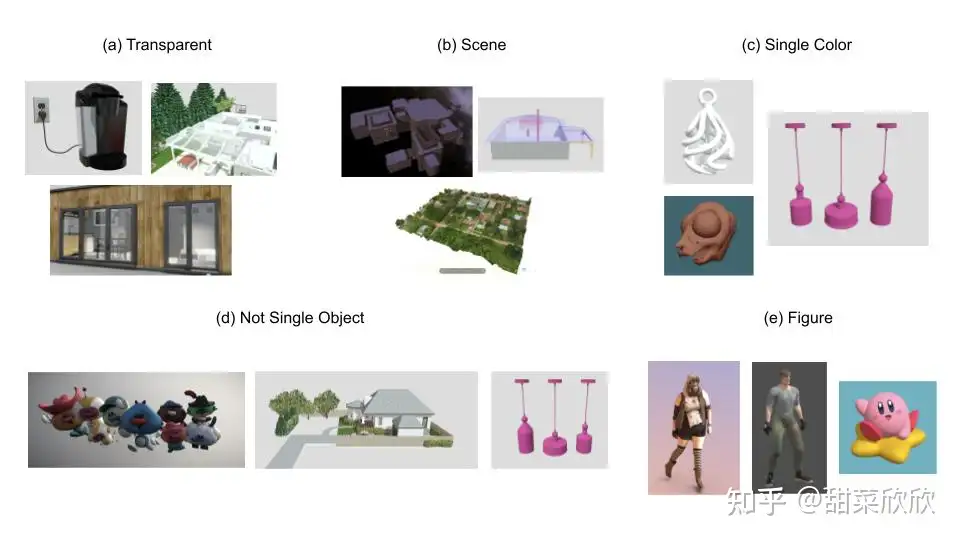
实验过程中有好几个点震惊到我。通过数据能看到 AI 的标记“逻辑”,比如当它要判断一个物品是否应该被归类为“场景”,就会在 3D 网格中寻找类似地面的平面。我们从未教 AI 这么做,是它自己找到了这个规律。
特别感谢 Abaka AI 和 Exascale Labs,让这个项目得以实现。很高兴有机会在由 George Cazenavette 等组织的 ICCV 研讨会“高效学习的数据精选(curated data for efficient learning)”上发言,该研讨会强调数据质量的重要性,这与当今的研究趋势尤其相关。
这篇论文的顺利收尾,也标志着欣欣的 AI 科研暂时告一段落。是时候落地生成式 AI,让大家的生活更加美好丰富~