MoE 可能会成为大语言模型未来的范式,无论大公司还是小公司都会用到它。
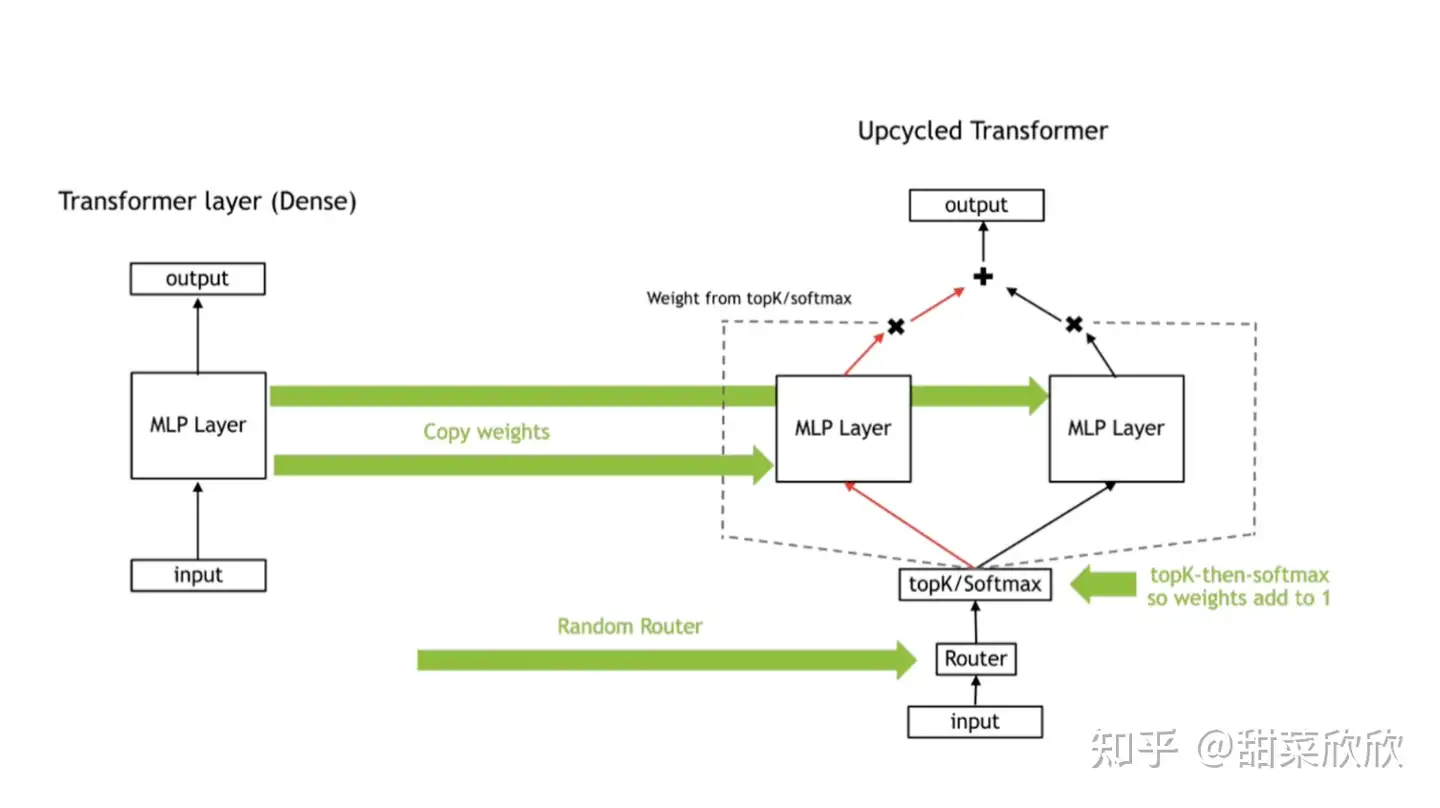
英伟达近日发布论文《大语言模型的混合专家模型升级改造》(Upcycling Large Language Models into Mixture of Experts)[1],提出了一种新的混合专家模型(MoE)训练方法。这项技术无需从零开始训练模型,而是通过改造现有的稠密模型,就能将其扩展到更大规模。
论文的第一作者、英伟达深度学习工程师
@何宜晖 (Ethan He)接受欣欣采访,介绍说该方法已在 Megatron Core 开源框架中实现,开发者可以直接在 GitHub [2]上获取相关代码。这项技术有望降低训练大模型的门槛,让更多机构和企业能够参与到大模型开发中来。
在这次技术访谈中,Ethan深入解析了混合专家模型(mixture of experts)的工作原理,并详细介绍了他们的最新研究成果。让我们一起了解 MoE 的过去,现状,和未来吧。
以下为中文翻译逐字稿。英文原视频
自我介绍
欣欣:能先介绍一下你在英伟达的工作吗?
Ethan:大家好,我是 Ethan He。我是英伟达的一名深度学习工程师,我的工作是大语言模型训练,并将 transformer 模型扩展到大规模,还有混合专家模型(MoE)。
什么是混合专家模型?
欣欣:有些人可能不太熟悉混合专家模型这个术语,你可以给我们简单科普一下吗?
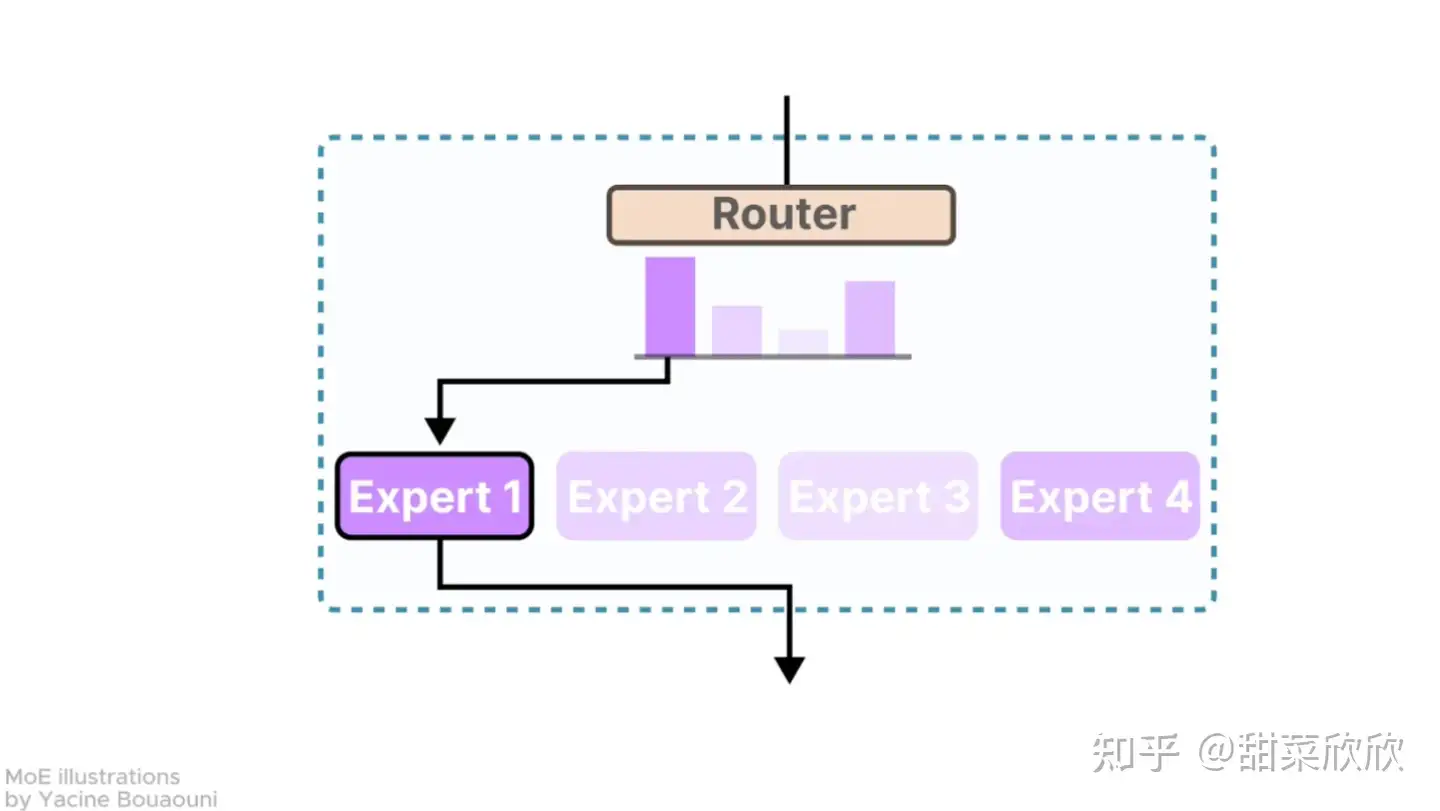
Ethan:你可以把它想象成一个单一模型,但它将几种模型组合在一起。根据你问的问题,它会选择性地激活一些专家来回答你的问题。
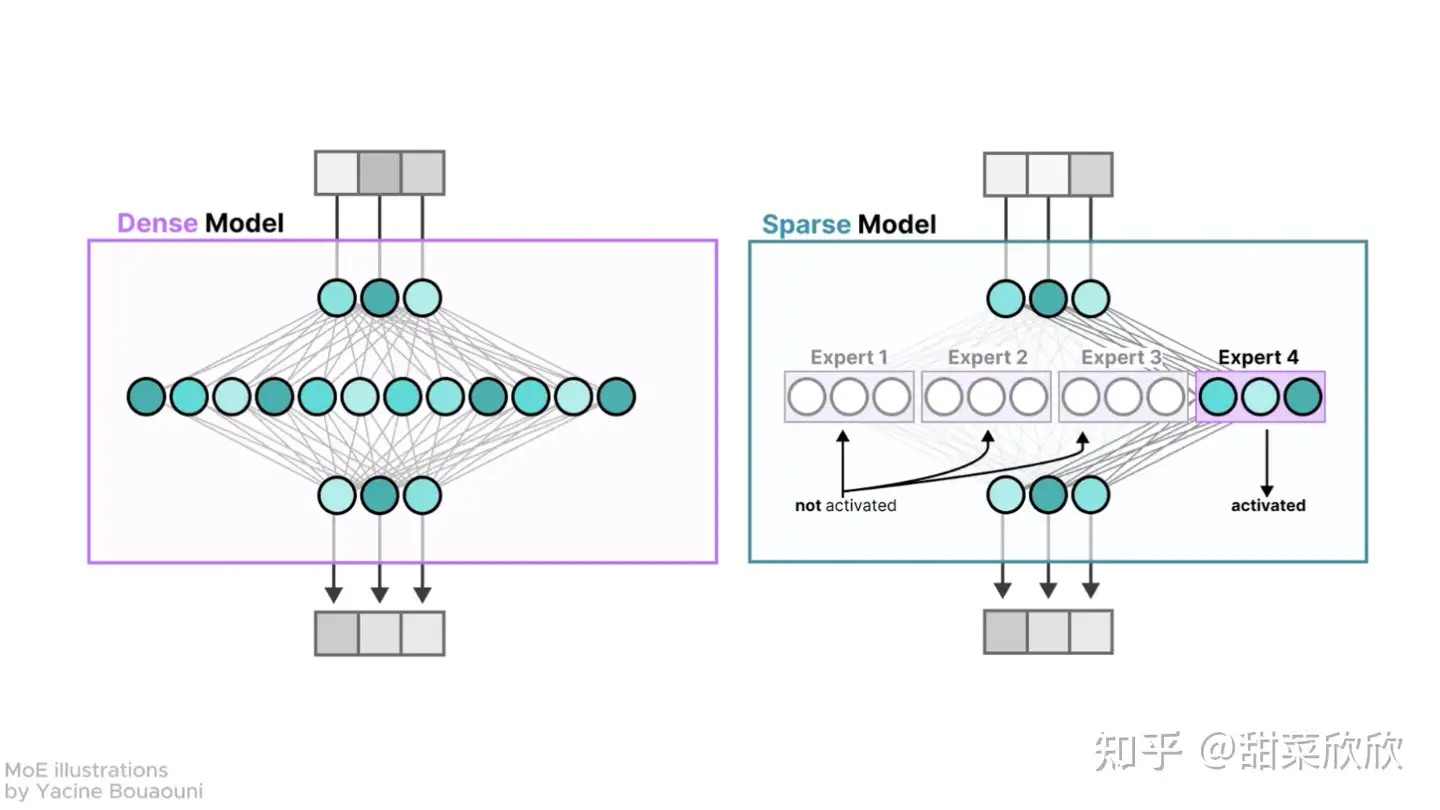
你可能听说过 LLaMA 模型或 GPT 模型,这些模型大部分都是稠密模型(dense models)。所有神经元几乎都被激活在模型推理的环节,所以是稠密的。然而对于混合专家模型来说,它是’稀疏激活‘的模型,意思是你输入的时候,只有一部分模型会被激活。
欣欣:那具体是用什么算法来决定该激活哪个专家呢?
Ethan:这个决定用哪个专家的组件叫“路由器(router)”。路由器其实就是一个非常小的神经网络,可以决定激活哪个专家。在推理阶段,根据你的输入,它会生成一个概率分布,覆盖所有专家的领域,然后选择排名靠前的 K 名专家来回答问题。
欣欣:每位专家负责不同的领域或者是模型的不同方面吗?
Ethan:并非完全如此。有些人试图解释每个专家是否会学到不同的东西,但神经网络擅长学到错综复杂的知识,所以很难辨别这位专家到底学习的是哪个领域。这不像是这个专家是学数学的,另一个专家学艺术,不是这样的。不过有一些基础的,比如有些专家专注于视觉 token 的泛化处理,有的专家则负责跨 token 的关联。
欣欣:跨 token?
Ethan:是的,就像 token 之间的关系。
模型优势和场景
欣欣:那么和传统方法相比,用这个方法建立大语言模型有什么主要优势呢?
Ethan:混合专家模型可以将模型规模化到下一级别。比如说 LLaMA 模型,最大的模型扩展到了 405B。如果你还想更进一步扩展,要么需要更多 GPU,要么就用 MoE 混合专家模型。比如说,你可以把同样的 LLaMA 405B 模型扩展到 2 万亿参数,而且需要的算力不会显著增加。
欣欣:业界中谁需要这样的扩展技术或者构建更大的大语言模型呢?
Ethan:几乎每个人都会需要。它马上就会变成一项必须的技术,无论小公司还是大公司。对于像 OpenAI 这样的大公司,他们的 GPT-4 传闻也用了混合专家模型。它在大规模上效率更高,因为这个模型是稀疏激活的。你可以省更多钱,对于小公司来说,用这个训练比训练一个稠密模型划算多了。我觉得这会成为构建大语言模型的行业标准。
论文背景
欣欣:让我们深入聊聊你和你的团队刚发表的论文吧。你们的论文主要是想解决什么样的问题?
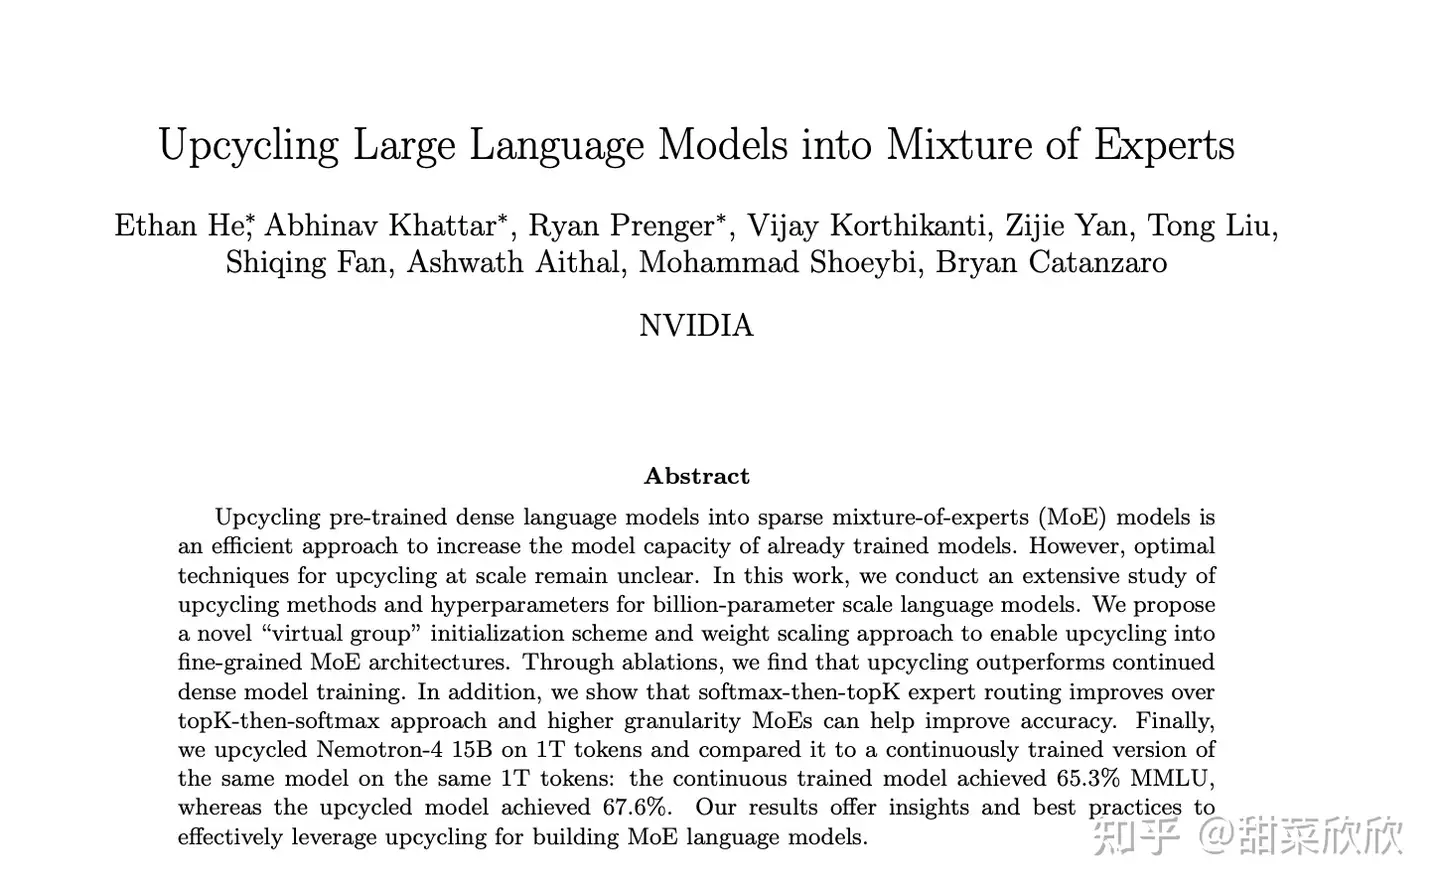
Ethan:我们想解决的是大规模扩展的难题。扩展的意思是,不需要从头训练这个混合专家模型,而是对现有的稠密模型进行改造,然后再训练,比如多训练几千个,或者经过数十万次迭代,打造出更好的模型。
欣欣:你的论文会落地使用吗?
Ethan:它已经开源在我们的 Megatron Core 里了。我们已经发布了功能,把大语言模型进一步扩展成更大的模型。你可以在 GitHub 上找到代码。
欣欣:如果现在有人想扩展一个混合专家模型,他们可以直接去 GitHub 下载代码,对吧?
Ethan:没错。
技术细节
欣欣:你们对不同参数做了实验,例如学习率(learning rate)和批大小(batch size)。你们发现混合专家模型需要更低的学习率和更大的批大小,这很有意思。
Ethan:这是因为专家是稀疏激活的。每个专家接收到的 token 更少,也就是在训练时批大小更小,所以它就需要更大的批大小。
欣欣:那么关于负载平衡(load balancing),它对实验结果有什么影响?
Ethan:负载平衡是为了确保 MoE 可以把 token 平均分配给各个专家。我们发现负载平衡越少,效果反而越好。你想要模型自己学会如何分配 token,这样可以保证没有专家在摆烂,就不会有什么都学不到的专家。
欣欣:你们论文里还提到了”颗粒度(granularity)“这个词,你能解释一下这是什么意思吗?
Ethan:颗粒度就是把专家拆分成更小的专家。这样就会创造出更多的专家,比经典版的 8 个专家要多。这样的颗粒度可以提高灵活性和准确性。
欣欣:如果我们有更多专家,这个模型的表现就会更好吗?
Ethan:是的,但有个上限。我们测试到 200 个专家还是有效果的,但再多的话,模型就很难学会该转接给哪个专家。
欣欣:你们的论文还提到了共享专家(shared experts)的概念。
Ethan:共享专家的意思是有些专家永远在线。通常,专家是基于概率被选择的。概率最高的就会被选中,概率低的就不会被选中。但这些共享专家总是在线,他们是来学习不同领域之间的共性的。
欣欣:在实验过程中,有没有让你感到惊讶的地方?
Ethan:混合专家模型很难高效地训练,尤其是在大的规模下。如果你需要进行大量工程优化来训练模型,特别是超过 7B 或 16B 参数时。
欣欣:你们做这些实验需要多少个 GPU?
Ethan:在这篇论文里,我们使用了 0.3 yottaFLOPs 的算力,大概相当于 500 块 GPU 跑一个星期。
模型限制
欣欣:我们聊了很多混合专家模型扩展的优点,那它有没有一些局限性或者缺点呢?
Ethan:缺点正是它本身的优势。扩展只适用于当你已经有一个现成的稠密模型,想把它改造成混合专家模型。如果你没有一个训练好的稠密模型,那这个方法基本就没什么用。比如说,目前还没有好的 Mamba 模型,所以很难把扩展应用到 Mamba 上。
对未来的期待
欣欣:在混合专家模型的领域,你最期待什么?
Ethan:我期待看到越来越大的模型。目前最大的模型据说是 1.8 万亿参数的 GPT-4 混合专家模型。我认为还可以更大,让我们拭目以待,看未来会不会有。
[1] 英伟达论文: “Upscaling Large Language Models into Mixture of Experts” available at https://arxiv.org/abs/2410.07524.
[2] 开源代码: https://github.com/NVIDIA/Megat